Je winkelwagen is leeg
Producten die je toevoegt, verschijnen hier.
Crawl budget is het aantal URL's dat een zoekmachine zoals Google op je website kan en wil crawlen.
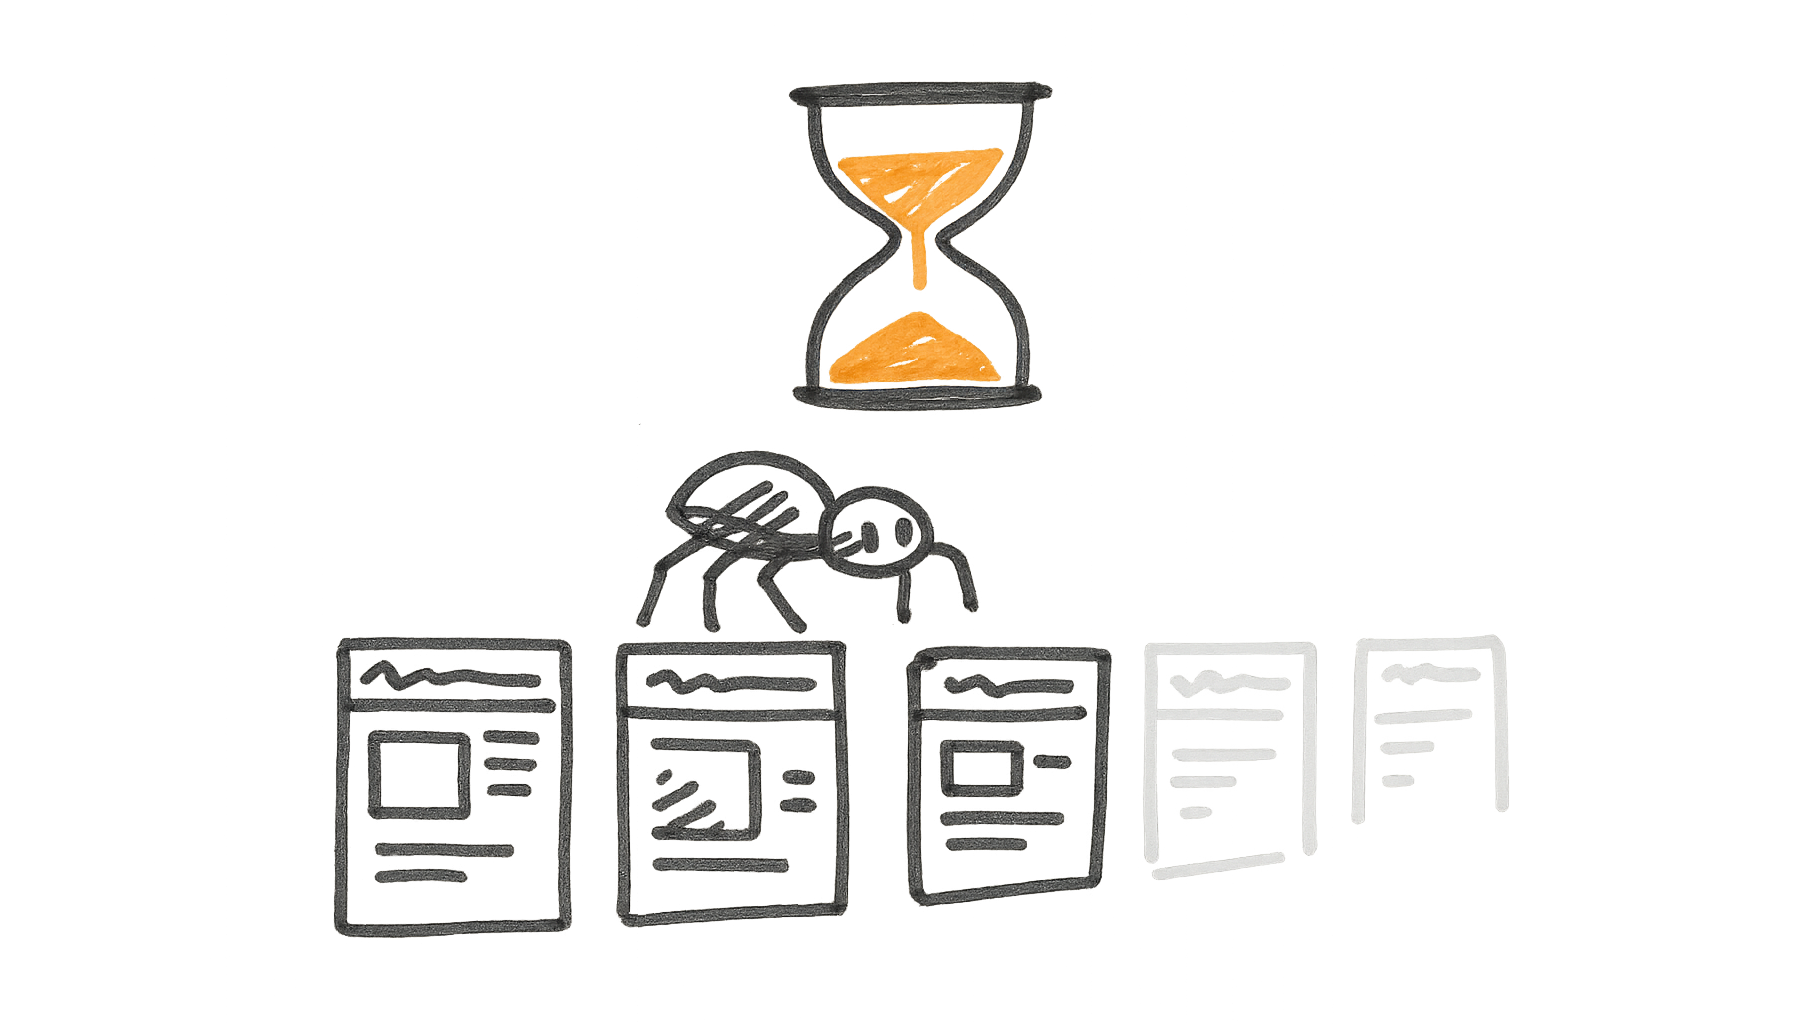
Crawl budget is de hoeveelheid tijd en verzoeken die Google maximaal aan het crawlen van je website besteedt. Google bepaalt dat budget per hostnaam, dus www.jouwdomein.nl en shop.jouwdomein.nl hebben elk een eigen budget.
Twee factoren bepalen het budget. De crawl capacity limit voorkomt dat Google je server overbelast. Reageert je server snel, dan crawlt Google meer, en bij trage antwoorden of serverfouten zoals een 503 juist minder. De crawl demand gaat over hoe graag Google je pagina's wil zien, en daarbij krijgen populaire en vaak gewijzigde pagina's voorrang.
Voor de meeste websites is crawl budget geen probleem. Google noemt het vooral belangrijk voor sites met meer dan een miljoen pagina's, en voor sites vanaf 10.000 pagina's waarvan de inhoud dagelijks verandert. Een bedrijfssite met een paar honderd pagina's wordt meestal gewoon goed gecrawld.
Verspil je budget niet aan URL's zonder waarde, zoals eindeloze filtercombinaties in een webshop, lange redirectketens en soft 404's. Blokkeer zulke URL's in robots.txt en houd je sitemap actueel. Het bestand robots.txt hoort in de hoofdmap van je site, op je hosting dus in public_html. Een subdomein heeft een eigen robots.txt nodig, omdat het bestand alleen geldt voor de hostnaam waarop het staat. Hoe Google je site crawlt, zie je in Google Search Console onder Instellingen, in het rapport Crawlstatistieken.
Over de term crawl budget circuleerden lange tijd veel verschillende definities. In januari 2017 legde Gary Illyes van Google uit wat de term voor Googlebot betekent, in de blogpost What Crawl Budget Means for Googlebot. Hij noemde twee onderdelen: de crawl rate limit en de crawl demand.
Belangrijke mijlpalen: